AMD ·
MI355X와 MI350P — HBM이 절반이어도 용량 대비 대역폭은 같습니다
기준원문 발표 2026-09-16확인 2026-10-21
근거AMD 공식 블로그·제품 페이지와 Tom's Hardware 사양 대조 완료; 가격·판매량·실측 처리량은 공개 자료에 없음
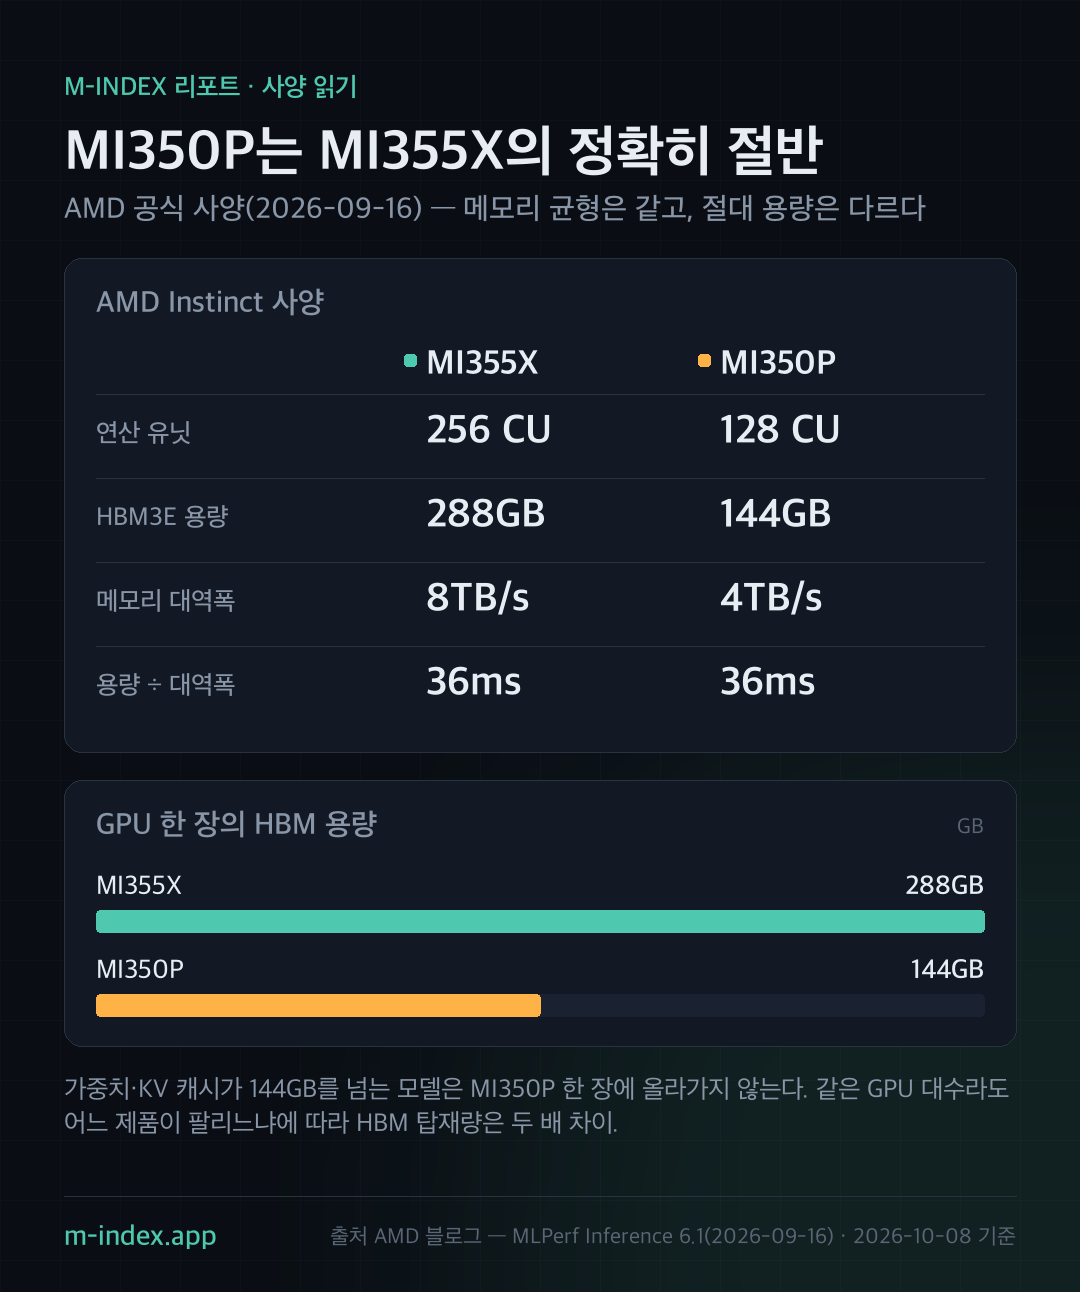
AMD MI355X는 HBM3E 288GB·8TB/s, MI350P는 144GB·4TB/s입니다. 용량과 대역폭이 같은 비율로 줄어 "용량을 한 번 다 읽는 시간"은 둘 다 36ms입니다. 가장 유력한 결론은 MI350P가 메모리 균형은 유지한 채 적재 가능한 모델 크기만 절반으로 줄인 제품이라는 것입니다.
AMD가 9월 16일 공개한 사양을 같은 단위로 맞추면, MI350P는 MI355X의 "절반짜리"지만 메모리 균형은 같습니다. 이 글은 새 제품 발표가 아니라 9월 자료를 다시 읽은 계산입니다. 메모리 투자자에게 이 비교가 의미 있는 이유는 GPU 한 장에 실리는 HBM이 제품 구성에 따라 두 배 차이 나기 때문입니다. 같은 1만 장이 팔려도 어떤 모델이 팔리느냐에 따라 HBM 수요가 달라집니다.
가설
질문은 이렇습니다. "HBM이 절반인 MI350P는 메모리가 상대적으로 부족한 제품인가, 아니면 단순히 작게 줄인 제품인가?"
- 가설 A(균형 유지). 연산 유닛, HBM 용량, 대역폭이 모두 같은 비율로 줄었으므로 용량 대비 대역폭이 같다. 그렇다면 같은 모델이 올라가는 한 단위 시간당 처리 구조는 비슷하고, 차이는 적재 가능한 모델 크기에서만 난다.
- 가설 B(메모리 부족). 카드 폼팩터가 PCIe로 바뀌면서 전력·냉각 제약이 생겨 실제로는 대역폭 활용이 달라지고, 기존 서버에 꽂는 용도라서 모델이 커질수록 한 장으로 부족해진다. 그렇다면 다중 카드 구성에서 카드 간 통신 한계가 비용을 키운다.
두 가설은 서로 다른 층위를 말합니다. A는 카드 안의 비율, B는 카드 밖의 시스템 구성입니다.
검증
1) 회사가 제시한 사양. AMD 공식 블로그와 Instinct MI350 시리즈 페이지를 기준으로 정리하면 다음과 같습니다.
연산 유닛, 용량, 대역폭이 모두 정확히 절반입니다. Tom's Hardware는 MI350P가 4,096비트 버스에 HBM3E 144GB, 최대 4TB/s이며 600W 전력 한도(450W로 낮춰 설정 가능)의 팬 없는 듀얼슬롯 PCIe 카드라고 전했습니다. 카드 하나의 이론 연산은 FP16 2.3PFLOPS, FP8 4.6PFLOPS로 적혔습니다.
2) 용량 ÷ 대역폭 = 36ms. 십진 단위로 8TB/s = 8,000GB/s, 4TB/s = 4,000GB/s입니다.
288 ÷ 8,000 = 0.036초, 144 ÷ 4,000 = 0.036초
두 제품 모두 HBM 전체를 이상적인 속도로 한 번 읽는 데 36ms입니다. 수학적 하한이어서 실제 접근 지연이나 토큰 하나를 만드는 시간은 아닙니다. 그래도 "작은 제품이라 메모리가 상대적으로 부족하다"는 해석은 사양상 성립하지 않습니다. 스택 단위로 보면 더 분명합니다. MI350P는 36GB 스택 4개(144GB), MI355X는 36GB 스택 8개(288GB)로 스택 하나의 용량도 같습니다.
3) 모델 적재 한계는 다르다. 비율이 같아도 절대 용량은 다릅니다. 가중치만 계산하면 700억 매개변수 모델을 FP8(1바이트)로 저장할 때 약 70GB이고, 4,050억 매개변수 모델은 약 405GB입니다. 전자는 MI350P 한 장(144GB)에 가중치가 들어가고 KV 캐시 여유도 남지만, 후자는 MI350P 세 장(432GB) 이상이 필요하고, MI355X 한 장(288GB)에도 올라가지 않습니다. 이 예시는 정밀도와 KV 캐시를 단순화한 산술이며 실제 배치는 런타임 오버헤드를 더 먹습니다.
4) 카드 밖 조건(가설 B). The Register 보도에 따르면 MI350P는 고속 칩 간 인터커넥트가 없어 카드 간 통신이 PCIe 5.0 속도(128GB/s)로 제한되고, 한 서버에 최대 8장을 꽂을 수 있습니다. 8장이면 HBM 합계는 1,152GB입니다. 그러나 카드 간 128GB/s는 카드 내부 4TB/s의 약 3% 수준이어서, 모델을 여러 장에 쪼갤수록 병목이 카드 간 통신으로 옮겨 갑니다. 같은 보도는 경쟁 제품(H200)과의 비교에서 FP8 이론 연산이 약 38% 높고 용량은 근소하게 앞서지만 메모리 속도는 H200이 약 20% 빠르다고 전했습니다. 이는 보도 인용이며 독립 성능 시험이 아닙니다.
판정. 가설 A는 사양상 완전히 지지됩니다. 가설 B의 "카드 안 메모리 부족"은 지지되지 않고, "카드 밖 통신 한계"는 부분적으로 지지됩니다. 따라서 둘의 차이는 메모리 균형이 아니라 적재 크기와 다중 카드 통신에 있습니다.
5) 폼팩터가 수요를 바꾸는 방식. MI350P는 기존 공랭 서버에 꽂을 수 있는 PCIe 카드라는 점이 핵심입니다. 액체 냉각이나 새 랙 설계가 필요한 OAM 제품은 도입 문턱이 높지만, 기존 서버에 카드를 추가하는 방식은 문턱이 낮아 도입 고객의 범위가 넓어집니다. 문턱이 낮아지면 구매 대수는 늘 수 있으나 장당 메모리는 절반이므로, HBM 수요에 미치는 순효과는 두 힘의 곱입니다. 예를 들어 같은 HBM 총량을 기준으로 MI350P가 MI355X 판매 한 장을 두 장으로 바꿔 놓으면 HBM 총량은 같고, 두 장 이상으로 바꾸면 늘어납니다. 이 산술은 대체 관계를 가정한 것이며 실제 시장에서는 서로 다른 고객이 사는 경우가 많아 단순 대체가 아닙니다. 그래서 이 글은 판매 믹스를 가정하지 않고 출하 비중이라는 관측 변수를 다음 확인 대상으로 둡니다.
결론
현재 근거로 가장 유력한 결론은 MI350P가 메모리 균형은 MI355X와 같게 유지한 채 한 장에 적재 가능한 모델 크기만 절반으로 줄인 제품이라는 것이다. 근거는 ① 연산·용량·대역폭이 정확히 절반이고 용량 ÷ 대역폭이 둘 다 36ms라는 사양, ② 스택당 용량(36GB)이 같다는 구성, ③ 카드 밖 한계가 메모리가 아닌 PCIe 인터커넥트라는 보도다. 이 결론은 사양 계산에 기반하므로 확신도가 높다.
틀릴 조건은 실측입니다. 같은 모델·정밀도·컨텍스트·배치에서 MI350P의 지속 대역폭이 4TB/s에 크게 못 미치거나, 450W 모드에서 성능이 비례 이상으로 떨어지면 "균형 유지"라는 결론은 사양상 수치에 그칩니다.
인사이트
업황. HBM 수요는 GPU 판매 대수가 아니라 모델별 탑재량의 합입니다. MI350P가 기존 공랭 서버에 꽂는 형태로 보급되면 서버당 GPU 대수는 늘어도 장당 HBM은 144GB로 낮아, 같은 판매량에서 HBM 비트는 MI355X 중심 믹스의 절반 수준이 됩니다. 반대로 접근 가능한 고객이 넓어지면 총 장수가 늘어 상쇄될 수 있습니다. 이 곱셈의 두 항 중 어느 쪽이 클지는 출하 믹스가 정합니다.
실적과 밸류에이션. 기본 시나리오(가능성 가장 높음)는 MI350P가 엔터프라이즈 추론의 저변을 넓히되 HBM 비트 기여는 MI355X 계열이 계속 크게 가져가는 경우입니다. HBM3E를 공급하는 SK하이닉스·삼성·마이크론 입장에서는 AMD 믹스가 어느 쪽으로 기울든 36GB 스택 수요는 이어지지만, 장당 스택 수가 4개와 8개로 갈립니다. 강세 시나리오는 MI350P 출하가 크게 늘어 장 수 증가가 장당 탑재량 감소를 넘는 경우, 약세 시나리오는 대형 모델 수요가 MI355X로 쏠려 MI350P 비중이 작은 경우입니다.
투자자가 놓치기 쉬운 점. HBM 공급사 관점에서 AMD 믹스는 엔비디아 믹스와 따로 봐야 합니다. 같은 36GB 스택이라도 어느 GPU 플랫폼에 들어가느냐에 따라 인증 일정과 가격 협상이 다르고, 공급사별 점유율도 달라지기 때문입니다. 이 글의 계산은 AMD 제품 안의 비율만 다루며, 공급사별 배분은 공개 자료가 없어 추정하지 않았습니다. 그럼에도 MI350P처럼 장당 HBM이 절반인 제품이 늘어난다는 사실은, GPU 출하량 증가율과 HBM 비트 수요 증가율이 같지 않을 수 있다는 점을 알려 줍니다. 이 차이를 보지 않으면 GPU 매출 성장을 HBM 성장으로 곧바로 옮겨 적는 오류를 범하게 됩니다.
다음에 볼 숫자. ① 두 제품의 출하 비중(HBM 수요에 가장 직접적), ② 같은 조건의 토큰/s와 소비전력, ③ GPU당 가격(공개되지 않음), ④ 카드 8장 구성에서의 인터커넥트 병목 실측, ⑤ AMD 분기 실적에서의 Instinct 매출 성장률입니다. 가격과 판매량은 공개 자료가 없어 위 숫자로 간접 추적합니다.
출처
- 1차(회사 자료): AMD 공식 블로그 — MLPerf Inference 6.1 (2026-09-16), AMD Instinct MI350 시리즈
- 뉴스: Tom's Hardware — MI350P 발표, The Register — PCIe 기반 Instinct
읽는 법 안내
밑줄 친 말은 용어 위키로 이어집니다. 큰 숫자보다 먼저 누가 말했는지, 어떤 조건이 붙었는지, 아직 확인되지 않은 것이 무엇인지를 봅니다.
본문에 나온 용어
매주 월요일, 메모리 업황 요약을 메일로 받기
이어서 읽기
DeepSeek V4.1 Flash의 KV 캐시 890바이트 — HBM 수요가 줄어든다는 뜻일까HBM · 2026-09-10KV 캐시를 1/5로 줄인다는 TurboQuant, 어디까지 믿어야 하나AI 추론 · 2026-09-05Kimi K3 2.8T MoE와 HBM — 공개된 추론 구조, 공개되지 않은 학습 장비HBM · 2026-08-22편집 원칙 — 공개 원문 우선 · 사실·추정 분리 · 소개·편집 원칙
스레드 @m.index.kr 에도 매일 씁니다.이 글의 숫자는 공개 API 실측값이거나 회사가 직접 낸 발표문에서 가져온 것입니다. 지수와 점수는 제가 만든 계산의 결과이지 사실이 아니며, 계산식은 검증 페이지에 전부 공개돼 있습니다. 투자 자문이 아니고 매매 권유도 아닙니다.